Sigrid leitet den Kundensupport eines Unternehmens für Buchhaltungssoftware. Sechs Wochen lang hat ihr Team einen KI-Assistenten getestet, der einfache Anfragen beantwortet, bevor ein Mensch sie übernimmt. Im Auswertungsgespräch zeigt Darragh, der Produktmanager und größte Fürsprecher des Projekts, eine Folie.
„Drei Erfolge“, sagt er. „Die Zufriedenheit französischsprachiger Kunden ist gestiegen. Donnerstags melden sich weniger Kunden erneut. Und Anfragen zur Abrechnung werden elf Prozent schneller abgeschlossen. Der Assistent funktioniert.“
Sigrid schaut auf das Support-Dashboard ihres Laptops. Es erfasst rund dreißig Kennzahlen. Die meisten haben sich nicht verändert. Zwei sind sogar etwas schlechter geworden. Darraghs drei Erfolge beruhen auf echten Zahlen. Aber vor dem Test hatte niemand festgelegt, dass ausgerechnet die Zufriedenheit französischsprachiger Kunden oder erneute Kontakte am Donnerstag besser werden sollten.
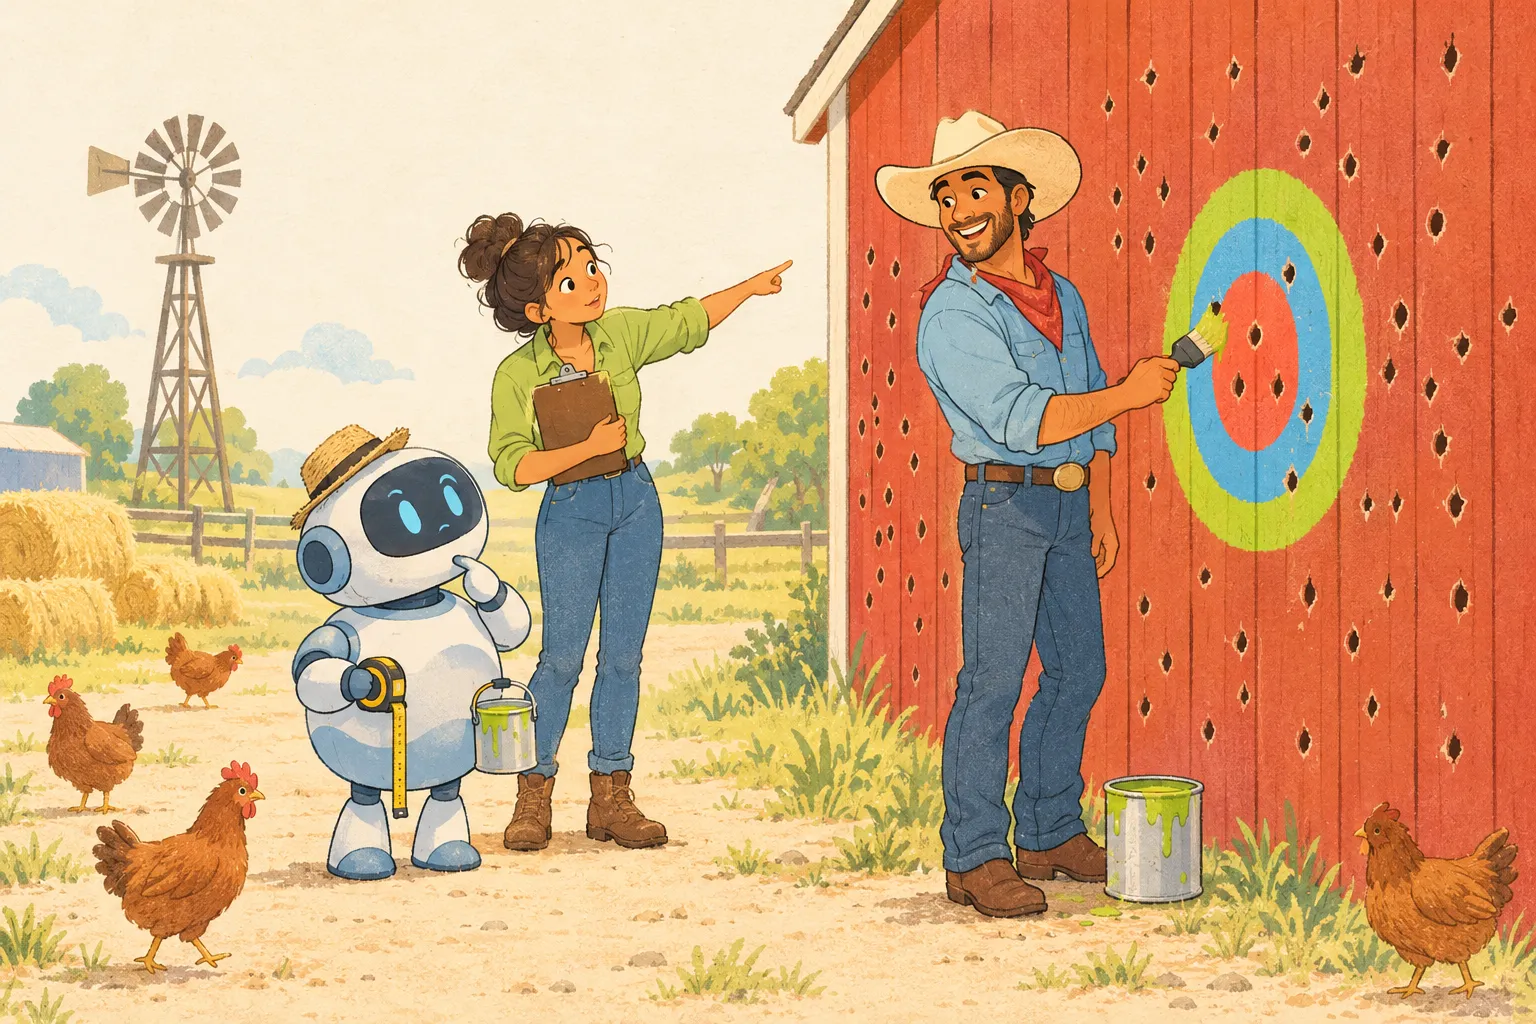
Darragh hat nicht gelogen. Er hat erst auf die Scheune geschossen und dann die Zielscheibe um die Einschusslöcher gemalt. Dafür gibt es einen Namen: Texas-Sharpshooter-Fehlschluss. In diesem Artikel erfährst du, was dahintersteckt, warum der Denkfehler so überzeugend ist, wo er auftritt und wie du ein echtes Muster von einer nachträglich aufgemalten Zielscheibe unterscheidest.
Was ist der Texas-Sharpshooter-Fehlschluss?
Beim Texas-Sharpshooter-Fehlschluss entdeckt jemand nach Sichtung der Ergebnisse ein Muster in Daten und behandelt es anschließend als aussagekräftig oder sogar als hätte man es von Anfang an vorhergesagt. Die Treffer stehen im Mittelpunkt, die Fehlschüsse bleiben unsichtbar. Dieselben Daten dienen zweimal: erst dazu, das Muster zu finden, und dann dazu, es zu „beweisen“.
Der Name stammt von einem alten Witz. Ein Mann schießt auf eine Scheunenwand. Danach malt er eine Zielscheibe um die Einschusslöcher, die besonders dicht beieinanderliegen. Wer die Scheune später sieht, hält ihn für einen ausgezeichneten Schützen.
Drei Merkmale verraten den Denkfehler:
- Die Zielscheibe kam nach den Schüssen. Die Behauptung entstand erst beim Blick auf die Ergebnisse, nicht vorher.
- Es gab viele mögliche Trefferflächen. Zahlreiche Kennzahlen, Gruppen, Zeiträume oder Orte kamen für ein auffälliges Muster infrage.
- Die Fehlschüsse fehlen. Niemand erwähnt die siebenundzwanzig Kennzahlen, die sich nicht verbessert haben.
In unserem Überblick über logische Fehlschlüsse ist das Eintrag 21. Hier schauen wir genauer hin, denn am schwierigsten ist es zu merken, wenn man selbst den Pinsel in der Hand hält.
Woher kommt der Name?
Wer den Witz zuerst erzählt hat, ist nicht bekannt. Zu den frühesten bekannten Erwähnungen in einer Fachpublikation gehört ein Artikel über die Hodgkin-Krankheit, den der Epidemiologe Seymour Grufferman 1977 in der medizinischen Fachzeitschrift Cancer veröffentlichte. Er verglich erst im Nachhinein erkannte Krankheitscluster mit der Geschichte des texanischen Schützen und erklärte, dass sich daraus nicht ablesen lässt, ob eine Häufung mehr als Zufall ist.
Dort fand die Idee auch eine besonders wichtige Anwendung: in der Epidemiologie. Bei jeder Häufung lautet die erste Frage, ob sie auch dann überraschend wäre, wenn nichts Ungewöhnliches dahintersteckt.
Warum zufällige Daten wie ein Muster aussehen
Was viele überrascht: Zufall verteilt sich nicht gleichmäßig. Wenn du Dinge zufällig verteilst, landen manche dicht beieinander und andere Bereiche bleiben leer. Unser Gehirn liest in solche Häufungen eine Bedeutung hinein.
Ein anschauliches Beispiel stammt aus London zur Zeit des Zweiten Weltkriegs. Während der Angriffe mit fliegenden Bomben behaupteten viele Menschen, die Einschläge würden sich an bestimmten Orten häufen. 1946 prüfte der Versicherungsmathematiker R. D. Clarke diese Annahme in einem kurzen Artikel im Journal of the Institute of Actuaries.
Er teilte 144 Quadratkilometer im Süden Londons in 576 Felder von jeweils einem Viertel Quadratkilometer auf und zählte die Treffer. In dem Gebiet waren 537 Bomben eingeschlagen. Bei einer rein zufälligen Verteilung waren statistisch etwa 227 Felder ohne Treffer und etwa 7 Felder mit vier Treffern zu erwarten. Tatsächlich waren es 229 beziehungsweise 7. Auch die übrigen Zahlen passten gut zur Zufallsverteilung. Clarke kam zu dem Schluss, dass das Ergebnis die Hypothese einer besonderen Häufung nicht stützte.
Manche Felder waren tatsächlich vier- oder fünfmal getroffen worden. Aber genau solche Häufungen bringt der Zufall hervor. Die Bedeutung wurde erst nachträglich hineingemalt.
Wer an genug Stellen sucht, findet einen Treffer
Der zweite Grund für die Überzeugungskraft des Fehlschlusses ist einfache Mathematik. Angenommen, jede Kennzahl in einem Dashboard hat allein durch Zufall eine Chance von 1 zu 20, eine „auffällige“ Veränderung zu zeigen. Wer 30 Kennzahlen prüft, sollte mit ein oder zwei auffälligen Ergebnissen rechnen, selbst wenn tatsächlich nichts passiert ist. In der Statistik heißt das Problem multiple Vergleiche: Je mehr Fragen du an dieselben Daten stellst, desto mehr scheinbare Antworten liefert der Zufall.
Beispiele für den Texas-Sharpshooter-Fehlschluss
Die meisten dieser Situationen kennst du vermutlich. In allen Fällen wurde das Muster erst in den Ergebnissen entdeckt und dann so präsentiert, als hätte jemand genau darauf gezielt.
| Bereich | Was der vermeintliche Scharfschütze sagt | Die nachträglich gemalte Zielscheibe | Die verschwiegenen Fehlschüsse |
|---|---|---|---|
| Dashboard im Job | „Das neue Tool hat drei wichtige Kennzahlen verbessert!“ | Drei Kennzahlen, die erst nach Sichtung der Ergebnisse ausgewählt wurden | Die 27 Kennzahlen ohne Verbesserung oder mit schlechteren Werten |
| Nahrungsergänzungsmittel | „Unsere Studie zeigt, dass es die Schlafqualität verbessert.“ | Einer von vielen untersuchten Endpunkten | Die übrigen Ergebnisse ohne Effekt |
| Prognosen | „Dieser Experte lag richtig: Fünf Vorhersagen sind eingetroffen!“ | Fünf nachträglich ausgewählte Treffer | Die fünfzehn falschen Vorhersagen |
| Geldanlage | „Mit dieser Strategie hättest du dein Geld seit 2015 verdreifacht.“ | Eine Regel, die an vergangene Kurse angepasst wurde | Hunderte getestete und verworfene Regeln |
Keines dieser Muster ist zwangsläufig falsch. Der Fehlschluss besteht darin, ein nachträglich gefundenes Muster wie eine bereits bewiesene Erkenntnis zu behandeln.
Krebscluster: Wenn viel auf dem Spiel steht
Das ist nicht bloß ein Rätsel für Statistiker. Wenn Menschen in einer Gemeinde den Eindruck haben, dass sich Krebsfälle häufen, macht ihnen das Angst. Sie verdienen eine fundierte Antwort.
Nach der Definition des US-amerikanischen National Cancer Institute liegt ein Krebscluster vor, wenn in einer bestimmten Personengruppe, einem abgegrenzten Gebiet und einem festgelegten Zeitraum mehr Krebsfälle auftreten als erwartet. Das NCI weist zugleich darauf hin, dass Krebs häufig ist. Deshalb können Fälle gehäuft erscheinen, obwohl zwischen ihnen kein Zusammenhang besteht. Es verweist auf eine Auswertung von Goodman und Kollegen aus dem Jahr 2012: Von 576 Untersuchungen vermuteter Krebscluster über einen Zeitraum von 20 Jahren ließ sich nur in 72 Fällen ein Anstieg bestätigen. Nur 3 davon konnten mit einer möglichen Belastung in Verbindung gebracht werden. In lediglich einem Fall wurde eine eindeutige Ursache gefunden.
Das heißt nicht, dass besorgte Nachbarn sich etwas einbilden oder Umweltursachen ausgeschlossen sind. Es heißt: Eine Häufung ist eine Frage, keine Antwort. Die Ursache muss untersucht werden. Sie lässt sich nicht einfach von einer Karte ablesen.
Texas-Sharpshooter-Fehlschluss, Cherry Picking und ähnliche Denkfehler
Der Texas-Sharpshooter-Fehlschluss hat nahe Verwandte. Sie treten oft zusammen auf, sollten aber unterschieden werden. Denn bei jedem hilft eine andere Frage.
| Denkfehler | Was passiert | Die entscheidende Frage |
|---|---|---|
| Texas-Sharpshooter-Fehlschluss | Ein Muster wird in den Ergebnissen entdeckt und nachträglich zum eigentlichen Untersuchungsziel erklärt | „Wurde das vorhergesagt, bevor die Daten vorlagen?“ |
| Cherry Picking | Passende Belege werden gezeigt und andere verschwiegen, um eine bereits bestehende Behauptung zu stützen | „Können wir alle Ergebnisse sehen?“ |
| Bestätigungsfehler | Du bemerkst und erinnerst vor allem, was zu deiner bestehenden Meinung passt | „Was würde ich erwarten, wenn ich falschliege?“ |
| Post-hoc-Fehlschluss | B folgt auf A, also muss A die Ursache von B sein | „Was hat sich zur selben Zeit noch verändert?“ |
| Survivorship Bias | Du siehst nur die Fälle, die übrig geblieben sind | „Wer fehlt in diesem Bild?“ |
| Voreilige Verallgemeinerung | Aus wenigen Fällen wird eine allgemeine Regel abgeleitet | „Auf wie vielen Fällen beruht das?“ |
| Clusterillusion | Zufällige Häufungen wirken bedeutungsvoll | „Wie stark würde sich das rein zufällig häufen?“ |
Am einfachsten unterscheidest du den Texas-Sharpshooter-Fehlschluss von Cherry Picking anhand der Reihenfolge. Beim Cherry Picking steht die Zielscheibe zuerst fest, dann werden passende Treffer gesucht. Beim Texas-Sharpshooter-Fehlschluss sind die Treffer zuerst da, und die Zielscheibe wird darum herumgemalt. In der Praxis verschwimmen die Grenzen oft.
Wann ein nachträglich entdecktes Muster völlig in Ordnung ist
Ein wichtiger Punkt fehlt in vielen Erklärungen: In bereits erhobenen Daten nach Mustern zu suchen, ist kein Fehler. So beginnen viele Entdeckungen. Problematisch wird es erst, wenn der nächste Schritt ausbleibt.
Ein Muster, das dir beim Durchsehen der Daten auffällt, ist eine Hypothese. Zur belastbaren Erkenntnis wird es erst, wenn du es anhand von Daten prüfst, mit denen es nicht gefunden wurde. Für die nachträgliche Darstellung einer Entdeckung als ursprünglich geplante Vorhersage gibt es in der Forschung einen eigenen Begriff: Der Sozialpsychologe Norbert Kerr nannte das 1998 HARKing, kurz für „hypothesizing after the results are known“, also eine Hypothese erst nach Kenntnis der Ergebnisse aufstellen. Kerrs Punkt war nicht, dass explorative Datenanalyse falsch ist. Irreführend ist es, eine solche Entdeckung als bestätigte Vorhersage auszugeben.
| Ehrliche Suche nach Mustern | Texas-Sharpshooter-Fehlschluss |
|---|---|
| „Uns ist aufgefallen, dass Abrechnungsanfragen schneller bearbeitet werden. Prüfen wir, ob das so bleibt.“ | „Abrechnungsanfragen werden schneller bearbeitet. Das Tool funktioniert.“ |
| Nennt die Zahl aller geprüften Kennzahlen | Erwähnt nur die Treffer |
| Prüft das Muster mit neuen Daten | Nutzt dieselben Daten zum Finden und Beweisen |
| Akzeptiert, wenn sich das Muster nicht wiederholt | Findet ein neues Muster, wenn das alte verschwindet |
Wenn sich das Muster nicht bestätigt, sagen solche „Scharfschützen“ selten: „Ich lag falsch.“ Stattdessen suchen sie eine andere Häufung an der Scheunenwand. Das ähnelt dem Verschieben der Torpfosten.
So erkennst du den Denkfehler: fünf Fragen
Du brauchst keine Statistikkenntnisse, um eine nachträglich gemalte Zielscheibe zu erkennen. Diese fünf Fragen helfen in den meisten Fällen.
1. Wann wurde die Zielscheibe gemalt?
„Hat vor der Auswertung jemand festgelegt, dass wir genau danach suchen?“ Wenn die Vorhersage vorher dokumentiert wurde, sagt ein Treffer etwas aus. Wenn nicht, ist er ein Hinweis, kein Beweis.
2. An wie vielen Stellen wurde gesucht?
„Wie viele Kennzahlen, Gruppen oder Zeiträume haben wir geprüft?“ Ein Treffer bei einer einzigen Prüfung ist beeindruckend. Ein Treffer bei dreißig Prüfungen ist ungefähr das, was der Zufall erwarten lässt.
3. Wo sind die Fehlschüsse?
„Was ist mit den Kennzahlen, die sich nicht verändert haben?“ Bitte darum, die ganze Scheunenwand zu sehen.
4. Ist die Gruppe auffällig speziell?
„Französischsprachige Kunden, die in den ersten zwei Wochen mobil unterwegs waren“ ist ein Warnsignal. Je mehr Bedingungen ein Muster braucht, desto wahrscheinlicher wurde es aus zufälligem Rauschen herausgeschnitten.
5. Zeigt es sich auch in neuen Daten?
Das ist die entscheidende Frage. Prüfe das Muster dort, wo es nicht entdeckt wurde: im nächsten Monat, an einem anderen Standort oder in einer anderen Stichprobe. Ein echtes Muster zeigt sich häufig erneut. Eine nachträglich gemalte Zielscheibe verblasst meist.
So reagierst du, ohne Streit anzufangen
„Das ist der Texas-Sharpshooter-Fehlschluss“ mag stimmen, hilft aber selten. Dein Gegenüber hört „Du schummelst“ und geht in die Defensive. Behandle das Muster lieber als interessanten Hinweis.
Eine einfache Vorgehensweise: Ergebnis anerkennen, nach den Fehlschüssen fragen, einen Test vorschlagen.
| Was du hörst | Was du sagen kannst |
|---|---|
| „Schau, drei Kennzahlen sind gestiegen!“ | „Gut zu wissen. Wie viele haben wir insgesamt erfasst? Ich würde gern auch die unveränderten sehen.“ |
| „Die Daten zeigen eindeutig, dass diese Gruppe am besten reagiert.“ | „Interessant. Wollten wir diese Gruppe von Anfang an untersuchen, oder ist sie erst nachträglich aufgefallen?“ |
| „In unserer Straße sind so viele Menschen krank. Das muss an etwas hier liegen.“ | „Das sollten wir dem Gesundheitsamt melden. Dort kann man prüfen, ob es mehr Fälle sind, als zufällig zu erwarten wären.“ |
| „Der Backtest zeigt, dass diese Strategie den Markt schlägt.“ | „Wie viele Strategien wurden vorher getestet? Und wie hat diese abgeschnitten, seit sie ausgewählt wurde?“ |
Gerade bei Menschen, mit denen du weiter zusammenarbeitest, ist der dritte Schritt wichtig. „Lass es uns sauber prüfen“ eröffnet ihnen die Möglichkeit, tatsächlich recht zu behalten.
Praxisbeispiel: Sigrid und der KI-Assistent
Sigrid sagte Darragh nicht, seine Folie zeige einen Fehlschluss. Sie sagte: „Einige dieser Ergebnisse könnten echt sein. Wenn ja, will ich das wissen. Können wir eine zweite Testphase machen und vorher festlegen, was als Erfolg zählt?“
Vor Beginn der zweiten Phase einigten sie sich auf einen kurzen Plan:
| Frage | Vereinbarung |
|---|---|
| Was soll der Assistent verbessern? | Die Zeit bis zur ersten Antwort und den Anteil der Anfragen, die ohne menschliche Hilfe gelöst werden |
| Was zählt als Erfolg? | Eine klare Verbesserung bei beiden Kennzahlen über vier Wochen |
| Was zählt als Misserfolg? | Keine Veränderung oder insgesamt schlechtere Zufriedenheitswerte |
| Was passiert mit den drei Erfolgen? | Sie werden als Hypothesen beobachtet: Wenn sie echt sind, sollten sie erneut auftreten |
| Was wird berichtet? | Alle Kennzahlen im Dashboard, nicht nur die guten |
Nach vier Wochen war das Ergebnis gemischt. Bei Abrechnungsanfragen kam die erste Antwort schneller, und mehr Fälle wurden ohne menschliche Hilfe gelöst. Dieser frühe Erfolg war also echt. Bei anderen Anfragen änderte sich nichts. Der Anstieg der Zufriedenheit französischsprachiger Kunden und der Rückgang erneuter Kontakte am Donnerstag waren verschwunden, wie es bei Zufallstreffern häufig passiert.
Das Unternehmen behielt den Assistenten für Abrechnungsanfragen und setzte ihn für die übrigen Anfragen nicht weiter ein. Darragh hatte nun ein Ergebnis, das er überzeugend vertreten konnte.
So ertappst du dich selbst dabei
Wir alle malen manchmal Zielscheiben. Es fühlt sich nach einer Beobachtung an, nicht nach Selbsttäuschung.
- Schreib deine Vorhersage vorher auf. Bevor du die Ergebnisse eines Tests, einer Produkteinführung oder einer neuen Gewohnheit prüfst, notiere einen Satz: „Wenn es funktioniert, erwarte ich X.“ Das dauert dreißig Sekunden.
- Zähl deine Schüsse. Wenn dir etwas auffällt, frag dich, wie viele andere Dinge du dir angesehen hast. Sei bei der Zahl ehrlich.
- Zeig auch die Fehlschüsse. Wenn du einen Erfolg teilst, erwähne, was sich nicht verändert hat. Das macht deine Erfolge glaubwürdiger.
- Sei bei allzu glatten Geschichten vorsichtig. Passt ein Muster perfekt zu dem, was du dir erhofft hast, solltest du besonders genau hinsehen.
So kannst du das mit KI üben
Eine nachträglich gemalte Zielscheibe zu erkennen, ist schwieriger, wenn die Präsentation vor dir liegt und die vortragende Person begeistert ist. In einer KI-Debatte kannst du die entscheidenden Fragen vorher üben. Auf Debatly diskutieren mehrere KI-Modelle und Charaktere deine Frage aus verschiedenen Perspektiven über mehrere Runden. Du kannst dich jederzeit einschalten. Am Ende fällt ein Richter ein begründetes Urteil.
- Stell ein Muster auf den Prüfstand. Gib eine Behauptung, die dir begegnet ist, in den Debattenraum ein, zum Beispiel: „Unsere neuen Onboarding-E-Mails haben die Kundenbindung bei Anmeldungen am Wochenende erhöht.“ Eine Seite soll sie verteidigen, die andere hinterfragen, wie das Ergebnis zustande kam.
- Hol eine Datenexpertin dazu. Frag Sofia, die Datenwissenschaftlerin, wie viele Vergleiche möglicherweise angestellt wurden und wie ein fairer Test aussehen könnte. Sie hilft dir, aus einem Hinweis einen Prüfplan zu machen.
- Lass einen Skeptiker nach Fehlschüssen suchen. Bitte Viktor, den Skeptiker, aufzulisten, was die Behauptung auslässt: andere Kennzahlen, andere Gruppen, andere Zeiträume.
- Lies das Urteil. Richter Alex erklärt, welche Argumente in der Runde überzeugt haben. Achte darauf, ob die erfolgreiche Seite eine vorher festgelegte Vorhersage vorgebracht hat oder nur eine auffällige Häufung.
Als Sigrid Darraghs Folie in einer Debatte prüfen ließ, fragte die kritische Seite schon in der ersten Runde, wie viele Kennzahlen das Dashboard erfasste. So ging Sigrid ins Gespräch und wusste, wie sie die Frage freundlich stellen konnte.
Eine wichtige Grenze
KI-Modelle haben keinen Einblick in deine Daten und können nicht feststellen, ob ein Muster echt ist. Das kann nur ein Test mit neuen Daten zeigen. Außerdem können sie für fast jedes Muster eine plausible Geschichte erfinden. Das ist der Pinsel des Scharfschützen in neuer Form. Viele Modelle neigen zudem dazu, deiner erkennbaren Meinung zuzustimmen (siehe warum KI dir zustimmt). Nutze die Debatte, um bessere Fragen zu stellen und einen Test zu planen. Die Antwort müssen weiterhin die Daten liefern.
Mal die Zielscheibe zuerst
Der Texas-Sharpshooter-Fehlschluss lässt ein zufällig gefundenes Muster wie eine eingetroffene Vorhersage aussehen. Die Gegenmaßnahme ist einfach: Lege vor dem Blick auf die Ergebnisse fest, worauf du zielst. Zähle alle Schüsse und prüfe das Muster anschließend mit neuen Daten.
Wenn dir diese Woche jemand ein beeindruckendes Ergebnis zeigt, stell eine Frage: „War das schon vor der Auswertung das Ergebnis, nach dem wir gesucht haben?“ Und wenn du selbst ein spannendes Muster gefunden hast, diskutiere es auf Debatly. Lass die Gegenseite zuerst nach den Fehlschüssen suchen. Probier es aus. Die verfügbaren Angebote findest du auf der Seite Preise.
“Texas-Sharpshooter-Fehlschluss: Beispiele und wie du ihn erkennst”